Il file che supera ogni controllo
I flussi di sicurezza dei file si basano su un presupposto raramente messo in discussione: un file appartiene a un unico tipo. Il rilevatore ne identifica il tipo e la politica lo indirizza di conseguenza. Ogni motore a valle analizza quindi il file in base a quel tipo: anti-malware, sandbox e sanificazione.
I file "polyglot" smentiscono questa supposizione. Un singolo flusso di byte può essere contemporaneamente un GIF perfettamente valido e un archivio Java perfettamente valido. Lo stesso trucco funziona con un JPEG che è anche un archivio RAR, oppure con un PDF che contiene un ZIP completo oltre la sua fine logica. Ciascuna parte è di per sé conforme agli standard, quindi nessun parser di formato individuale rileva alcun errore.
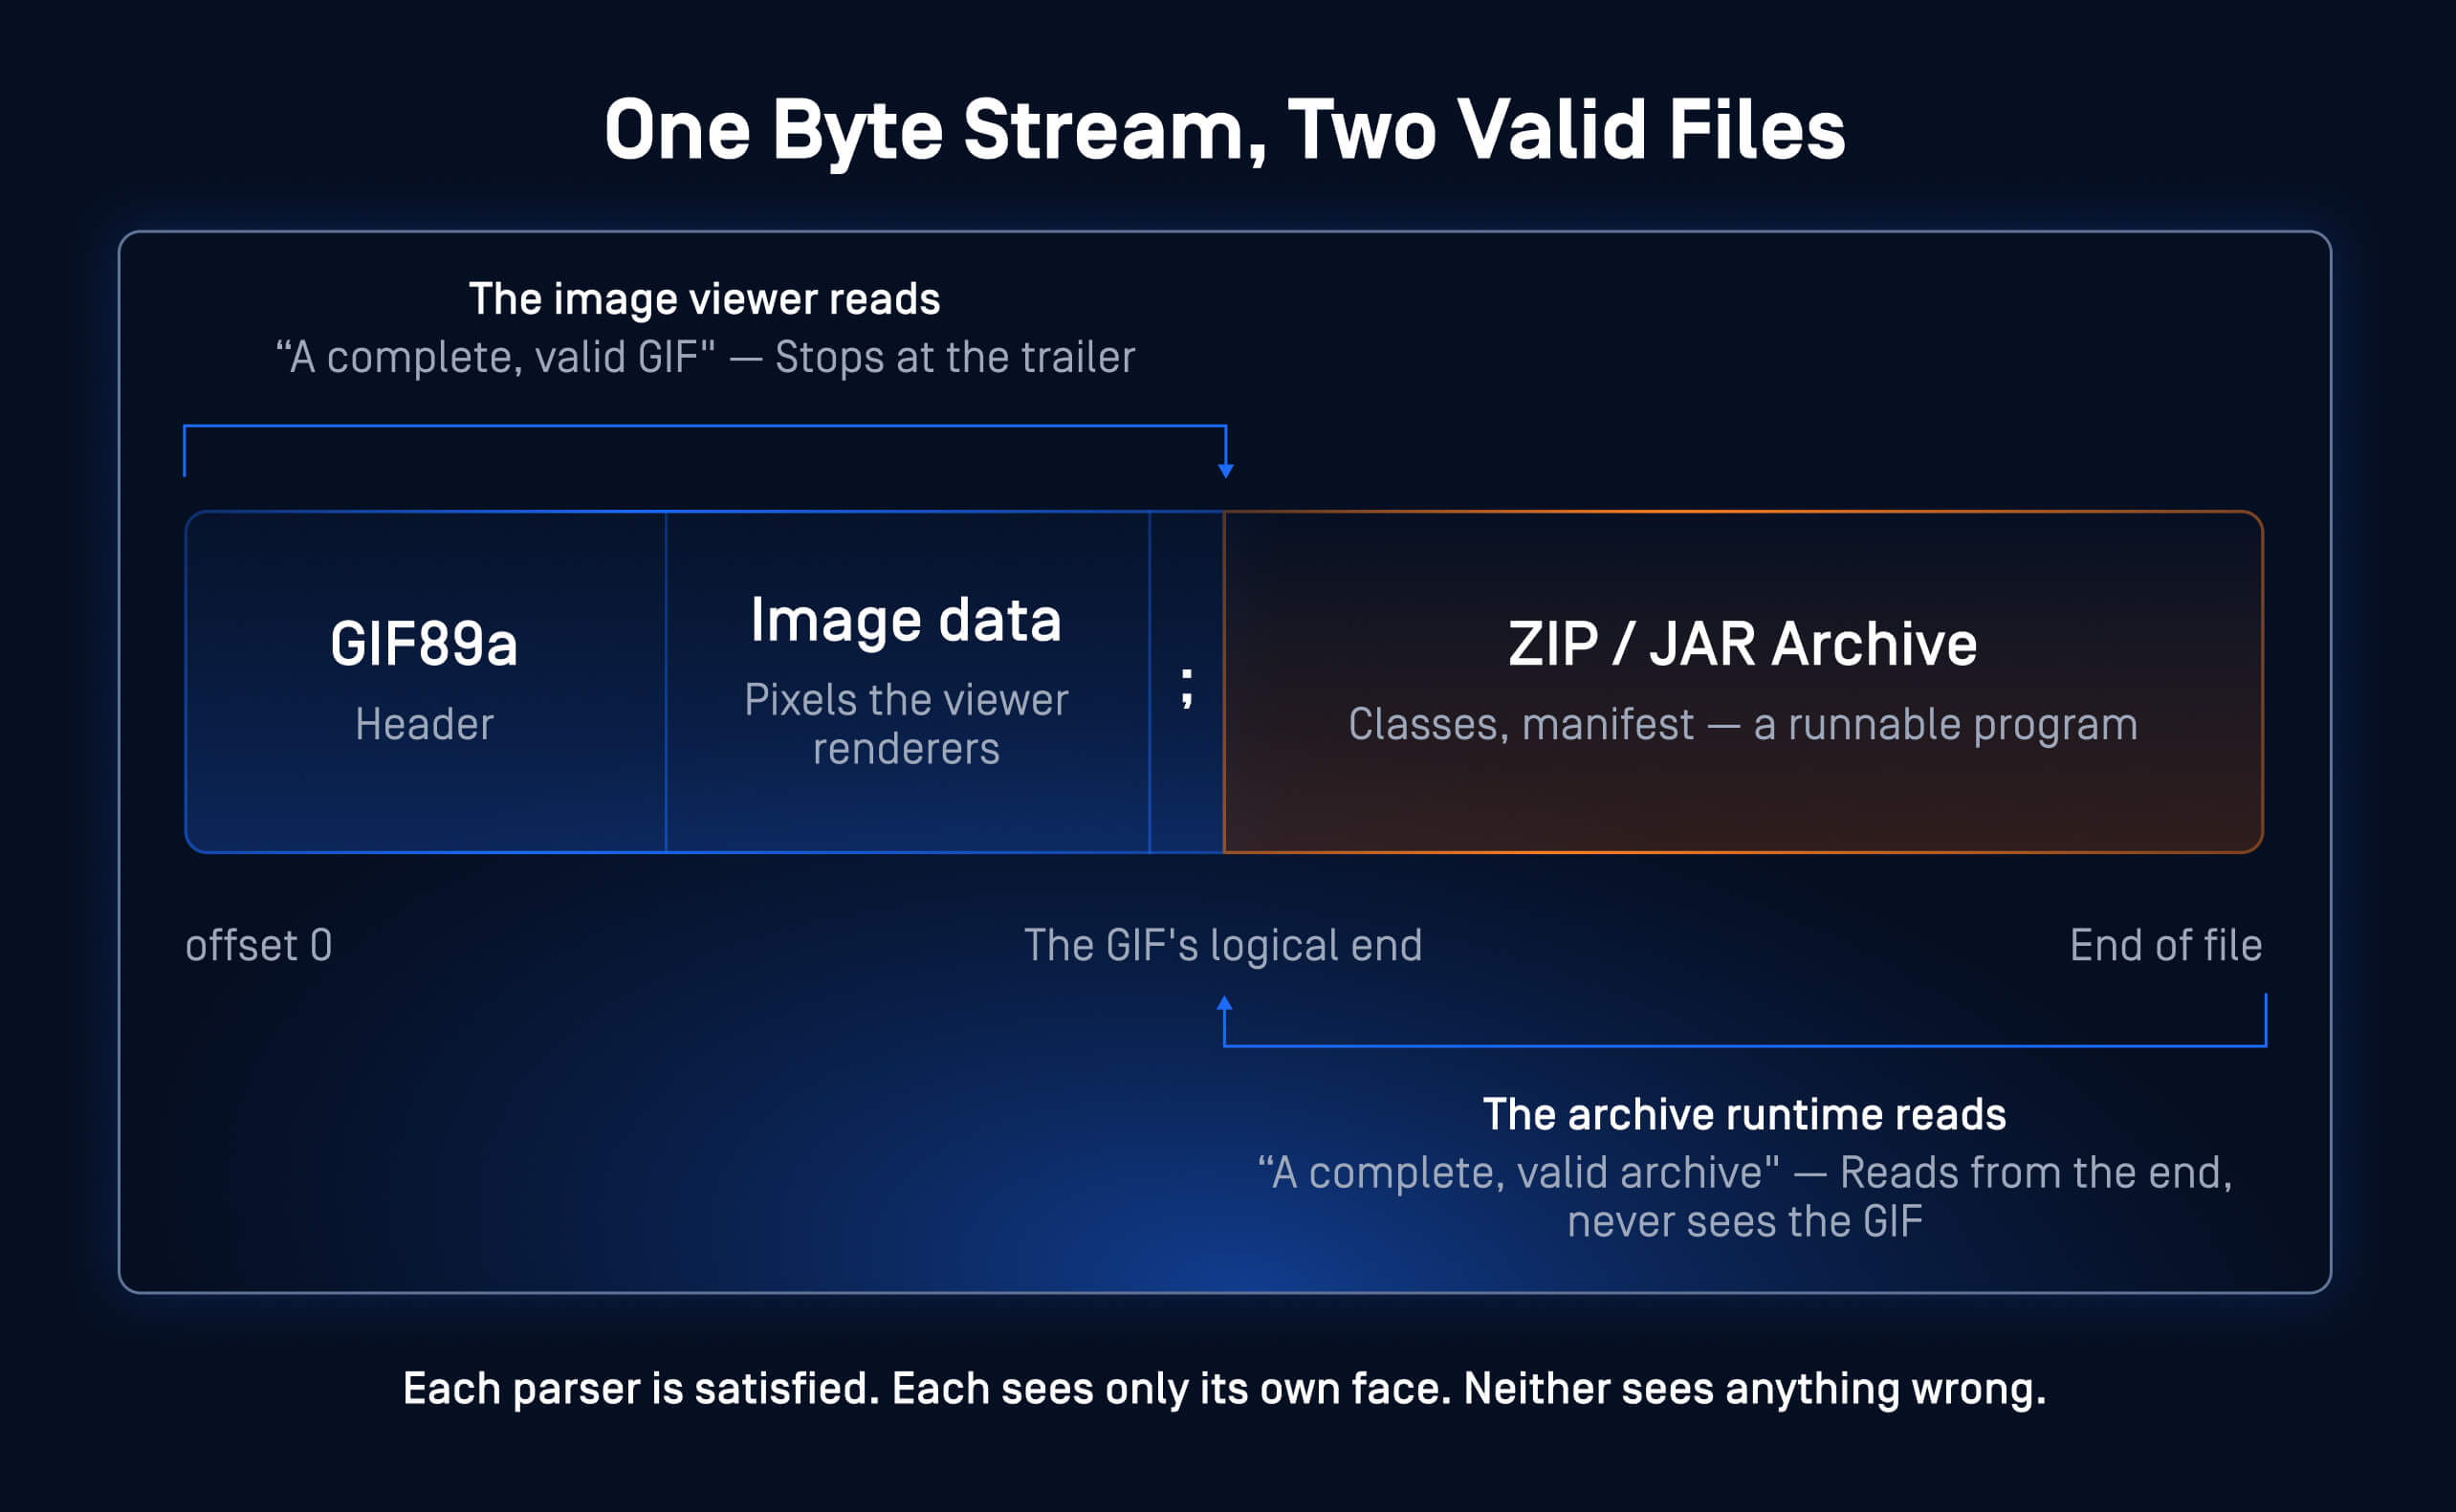
Un poliglotta in un'unica immagine: il classico GIF+JAR. Due parser, due punti di ingresso, un unico file e ogni volto perfettamente valido.
La conseguenza in termini di sicurezza è chiara: il pipeline analizza il file in base al tipo rilevato, mentre l’altro formato passa inosservato. Un’immagine che è anche uno script diventa un XSS memorizzato quando un’applicazione web la restituisce. Un archivio nascosto dietro la facciata di un’immagine trasporta il proprio payload oltre i filtri dei contenuti. Le catene di attacco basate su questa idea, dalla classica combinazione GIF+JAR alla distribuzione di exploit assistita dalla steganografia, sono note da quasi due decenni. I motori antimalware continuano a non rilevarle, poiché ogni elemento, esaminato singolarmente, risulta innocuo.
Come il motore trova un secondo volto
Il nostro motore di convalida della struttura dei file integra il rilevamento multilingue come fase di pre-elaborazione che viene eseguita su ogni file analizzato, prima di qualsiasi processore di formato. Il progetto si basa su tre principi.
- Analizza l'intero flusso. Lo scanner confronta l'intero file con un elenco di firme "magiche" dei formati. Qualsiasi secondo formato che si manifesti in qualsiasi punto del flusso viene individuato con il suo offset esatto, anche quando al file è già stato assegnato un tipo. Ciò include le firme aggiunte dopo il marcatore di fine file di un PDF o nascoste dietro i dati pixel di un'immagine.
- È importante sapere dove termina legittimamente un formato. I formati Container possono contenere legalmente altri file al loro interno. Un’immagine all’interno di un file ZIP è un contenuto ordinario. Il rilevatore individua la vera fine di ciascun contenitore sulla base della struttura del contenitore stesso. Il trailer di un PDF, la directory centrale di un ZIP e l’allocazione dei settori di un file composto OLE (Object Linking and Embedding) segnano ciascuno tale confine. L’analisi dei PDF tiene conto degli aggiornamenti incrementali. Solo le firme al di fuori di tale struttura vengono considerate come un secondo confine. È proprio questo confine strutturale a distinguere un vero risultato poliglotta da un falso allarme su ogni normale archivio.
- Verificare prima di formulare accuse. Il motore estrae ogni possibile candidato dal flusso e lo identifica in modo indipendente tramite il nostro motore File Type prima di segnalarlo. I candidati identificati come dati non strutturati vengono scartati. Un verdetto indica che un secondo formato viene effettivamente analizzato in quel punto. I byte magici isolati, da soli, non generano mai un verdetto.
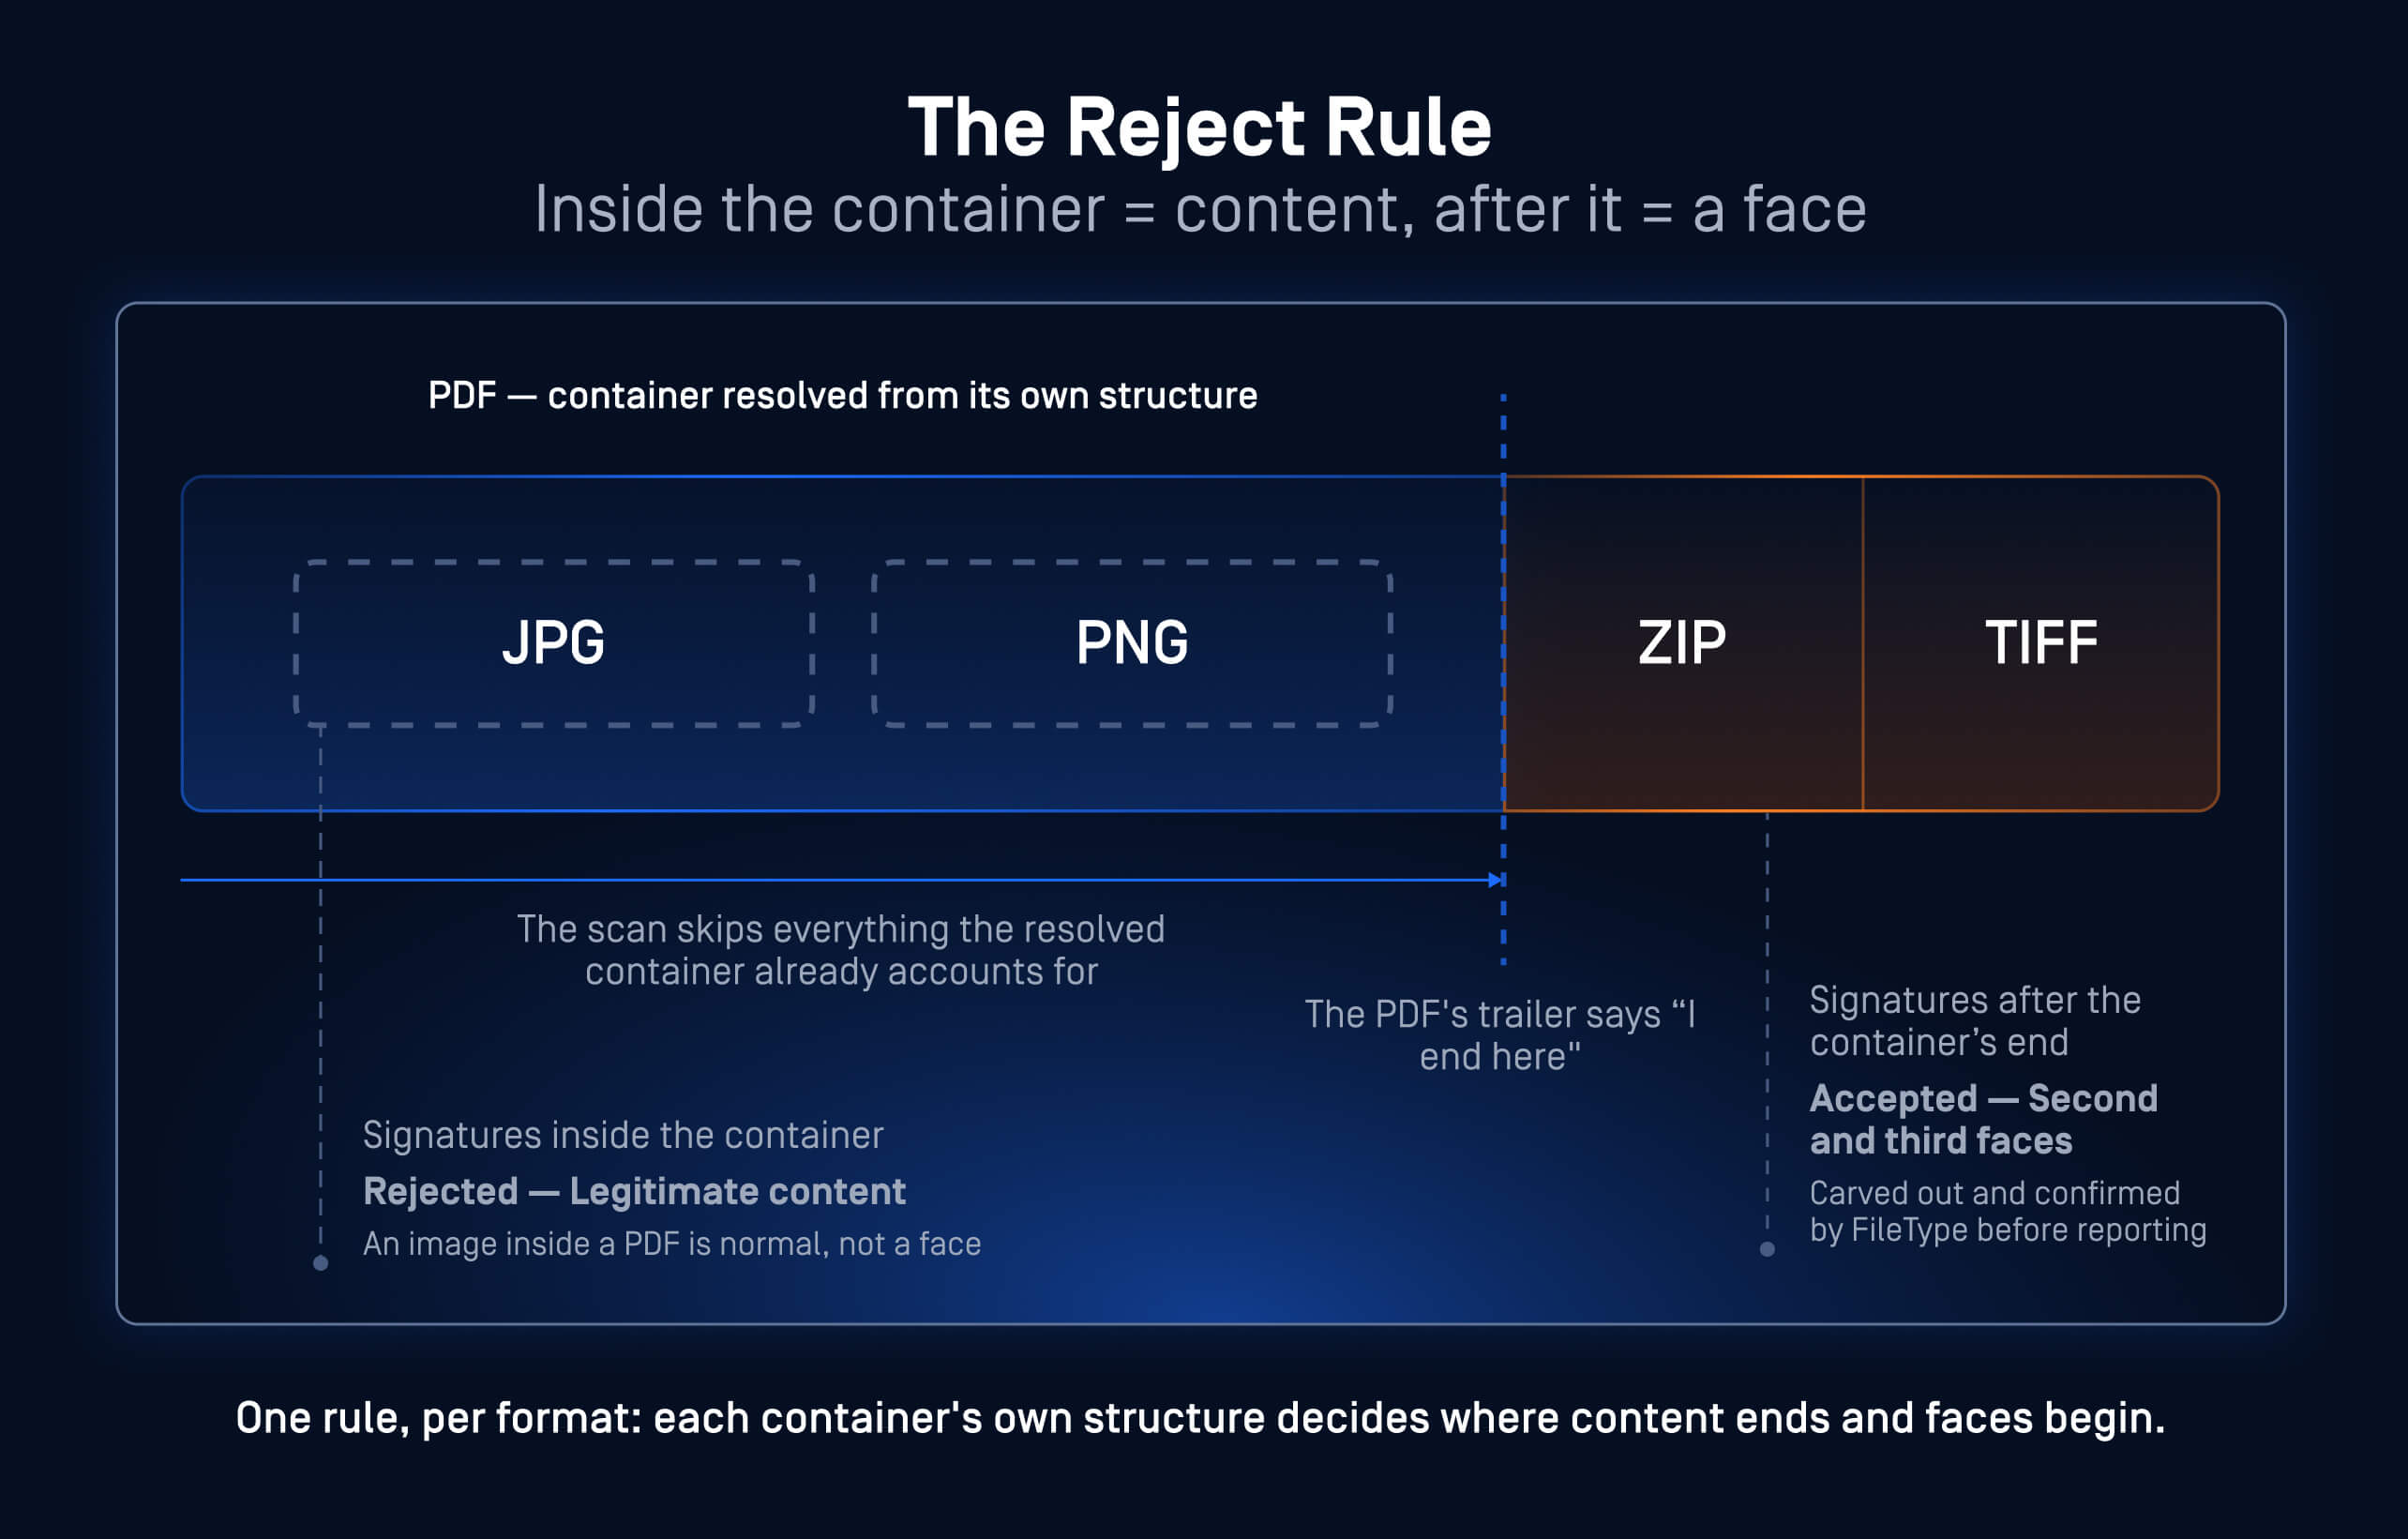
Estratto da un campione reale: un PDF che contiene un’immagine JPG e una PNG, con un file ZIP e un TIFF aggiunti dopo la sua fine logica. Il verdetto indica il file ZIP e il TIFF, ma non fa alcun riferimento alle immagini incorporate.
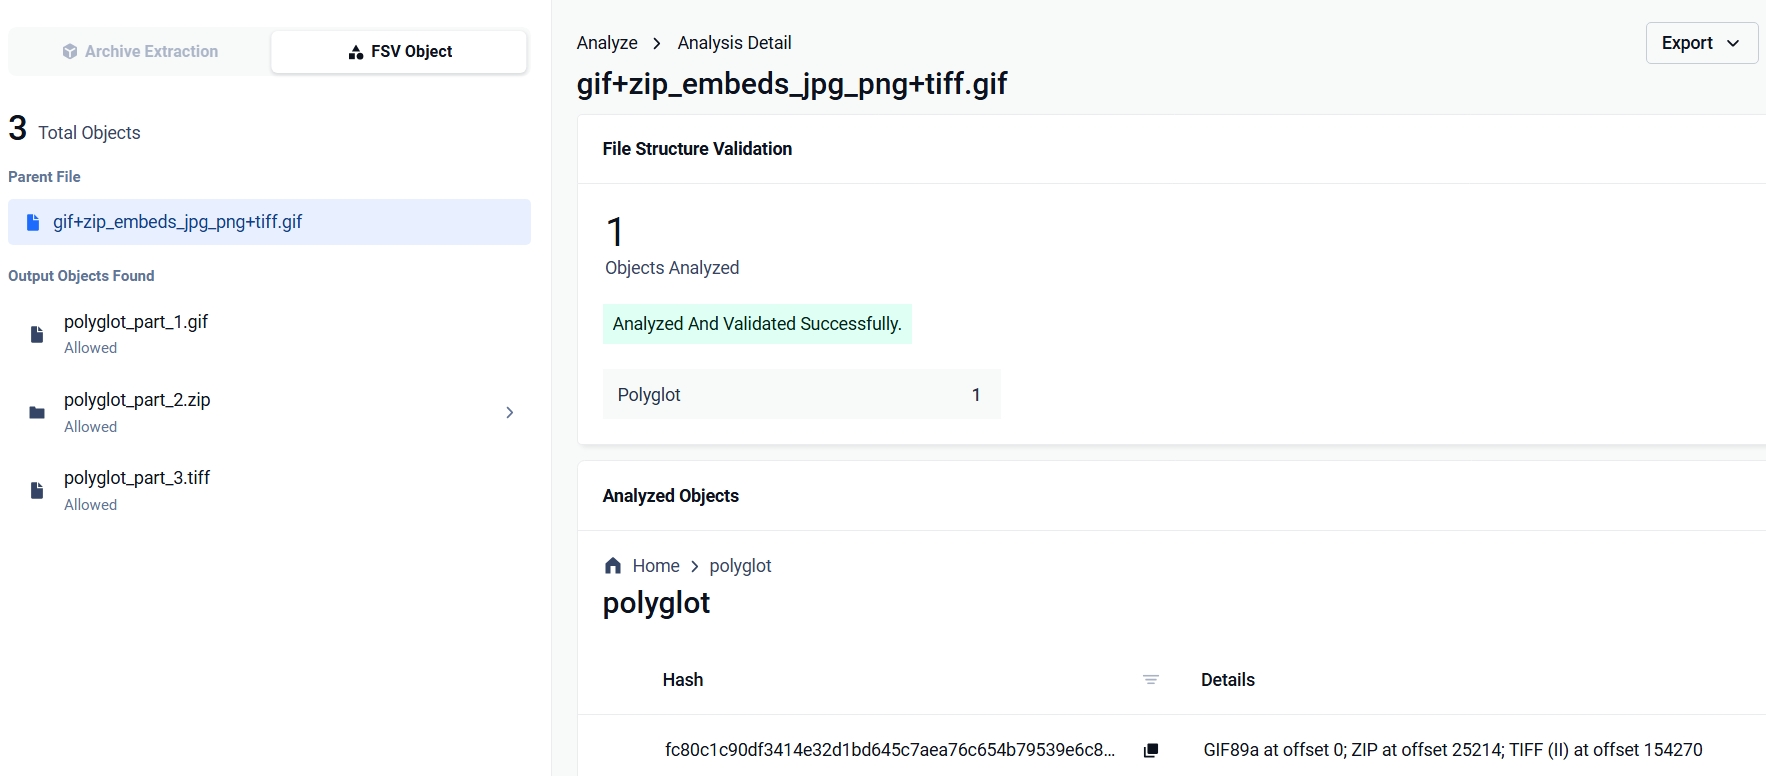
Il risultato riporta ogni faccia con il relativo offset. Il caricamento di un singolo file .gif, ad esempio, viene identificato come GIF89a all’offset 0 e come archivio ZIP più avanti nel flusso. La policy decide il resto: segnalare il risultato o bloccare direttamente il file con una spiegazione che elenchi i risultati trovati.
Dalla individuazione alla dissezione
Il rilevamento è solo metà della soluzione, perché il trucco del “polyglot” sta proprio nel fatto che ogni singolo volto sembra innocuo di per sé. Dopo il rilevamento, il motore analizza il file. Ogni volto confermato viene esportato come oggetto a sé stante (polyglot_part_1.pdf, polyglot_part_2.zip e così via) con il proprio formato, offset e dimensione. Il motore restituisce ciascuno di essi al flusso di lavoro diMetaDefender Core™ per l’elaborazione completa in base alla sua vera natura.
Abbiamo verificato tutto questo dall'inizio alla fine su un'istanza live di MetaDefender Core™.
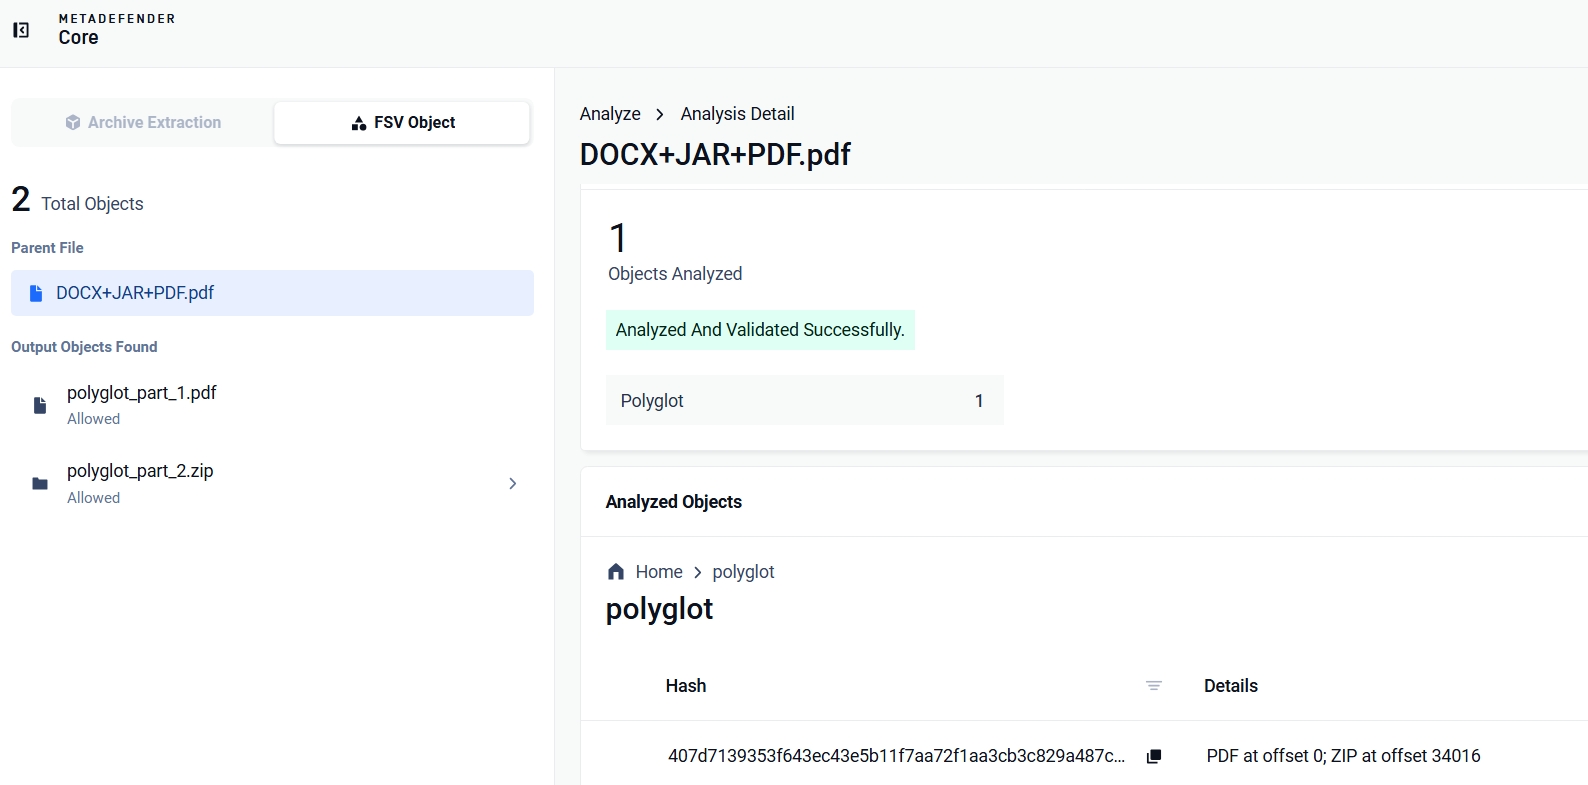
Il motore ha suddiviso un campione PDF che nascondeva segretamente un documento Word (un file poliglotta PDF+JAR+DOCX) nella sua parte PDF e nella sua parte ZIP. Poiché sia JAR che DOCX sono contenitori ZIP, una sola parte ZIP soddisfa entrambe le specifiche. Il motore File Type ha quindi identificato quella parte come DOCX e la tecnologia Deep CDR™ l’ha bonificata separatamente. La parte nascosta riceve lo stesso trattamento che era stata creata per eludere.
La precisione è la parte più difficile
I "magic byte" sono presenti naturalmente in file innocui, quindi il vero investimento ingegneristico consiste nel non dare l’allarme a sproposito. Le foto scattate con la fotocamera incorporano miniature EXIF che contengono la propria firma JPEG. I documenti di Office incorporano immagini all’interno della loro struttura contenitore. I file Media contengono in modo casuale sequenze di byte che assomigliano a intestazioni di compressione. La logica di rilevamento esclude i byte già contemplati da una struttura legittima, e questo rafforzamento viene continuamente esteso, formato per formato. Un rilevatore che segnala ogni foto scattata con una fotocamera viene disattivato, e un rilevatore disattivato non protegge nessuno.
Testato su veri poliglotti
Abbiamo sottoposto campioni reali di codice poliglotta a un'implementazione live di MetaDefender Core™ con il motore di convalida della struttura dei file. Tutti sono stati individuati, con ogni elemento individuato con precisione al byte:
Esempio | Volti rilevati (offset) | Risultato |
PDF che nasconde un documento Word (PDF+JAR+DOCX in un unico file) | PDF @ 0 · ZIP @ 34.016 | Volti rimossi; il file DOCX nascosto è stato ripulito grazie alla tecnologia Deep CDR™ |
GIF che nasconde un archivio e una seconda immagine | GIF89a @ 0 · ZIP @ 25.214 · TIFF @ 154.270 | Rilevato |
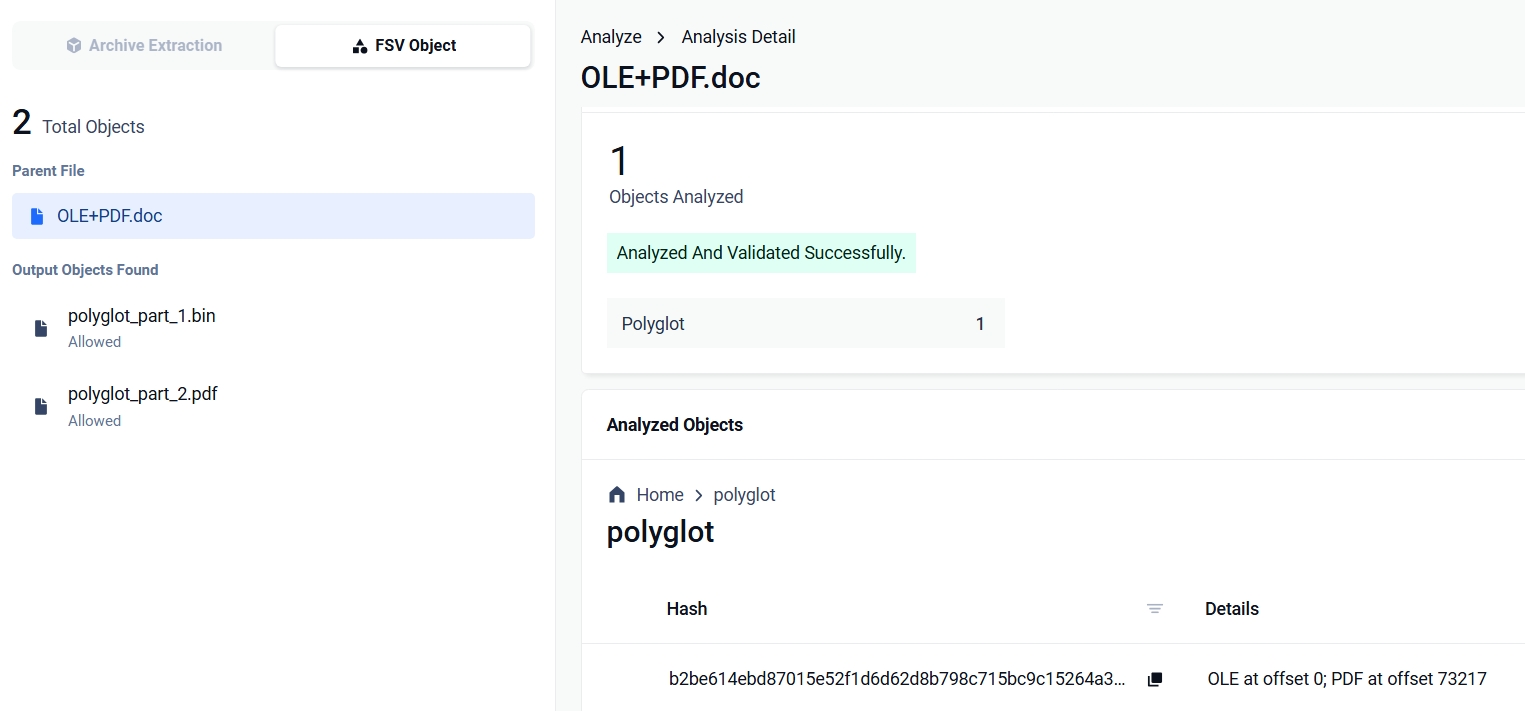
Documento di Office che nasconde un PDF | OLE @ 0 · PDF @ 73.217 | Rilevato |
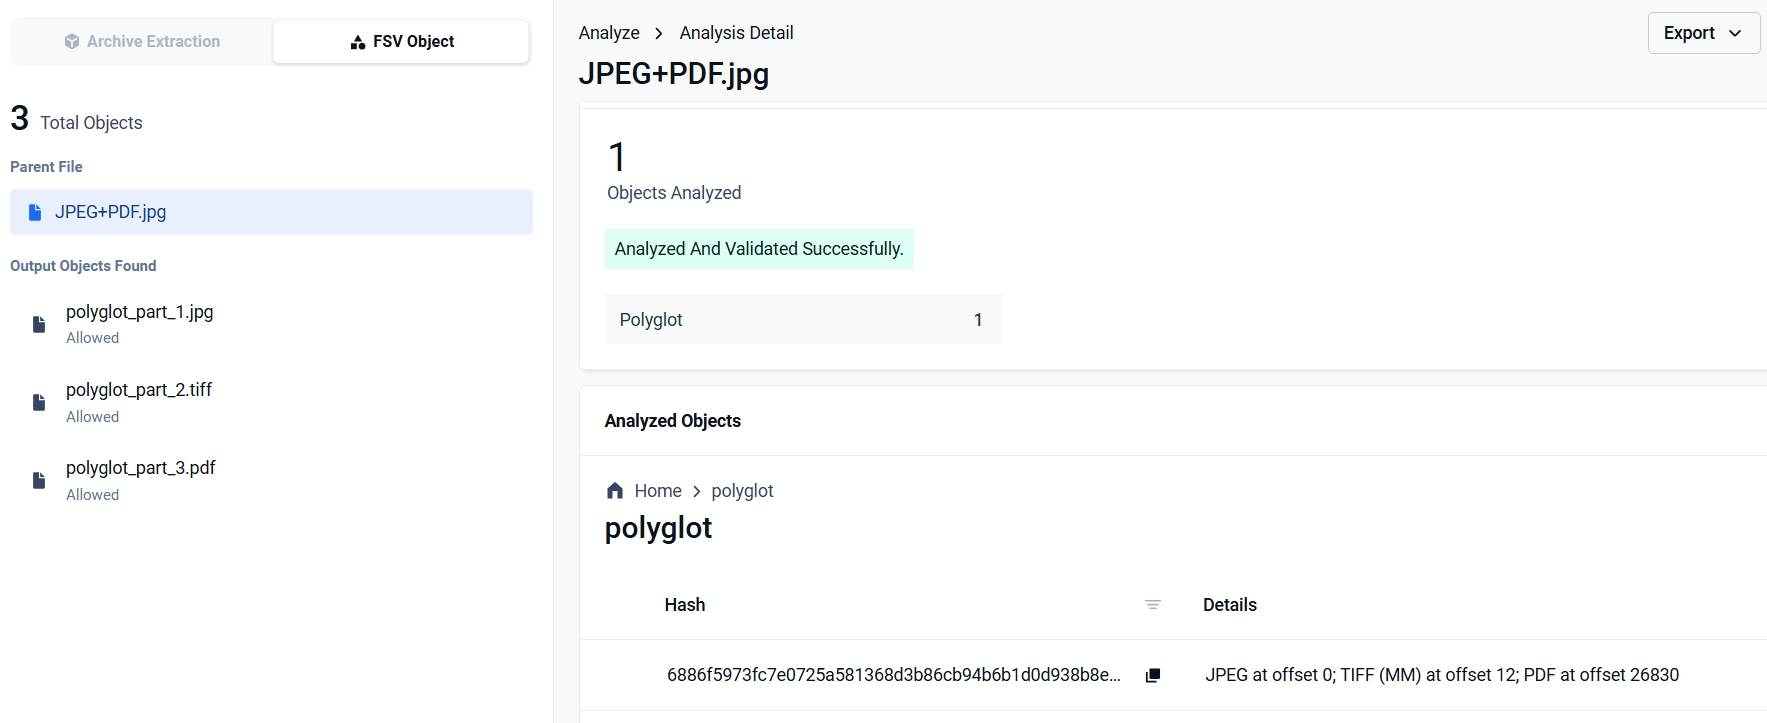
JPEG che nasconde un PDF | Tre facce, PDF allegato @ 26.830 | Rilevato |
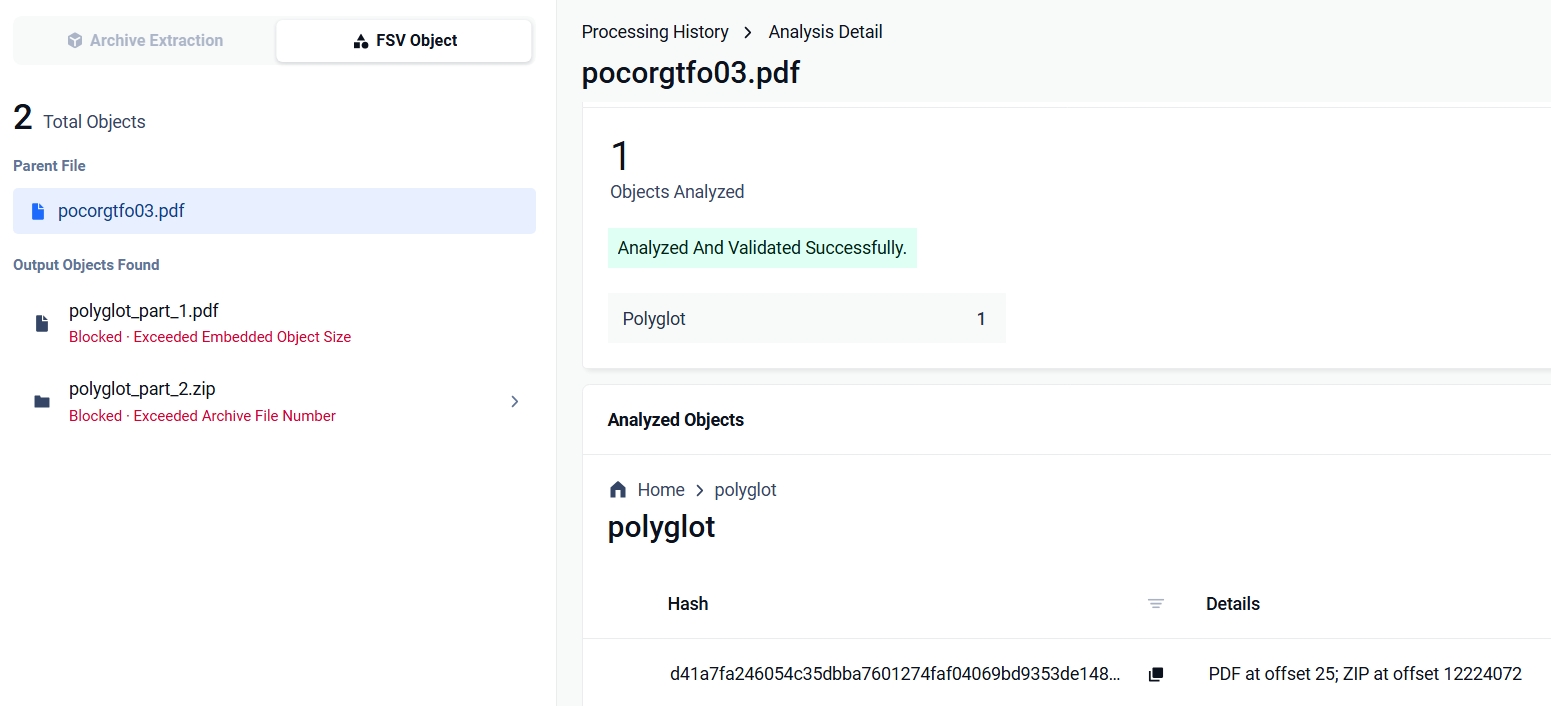
"PoC‖GTFO" n. 3, la rivista dedicata alla ricerca sulla sicurezza realizzata in formato PDF+ZIP multilingue, 26 MB | PDF @ 25 · ZIP @ 12.224.072 | Rilevato: il secondo file è stato individuato a 12 MB di profondità durante la scansione completa |
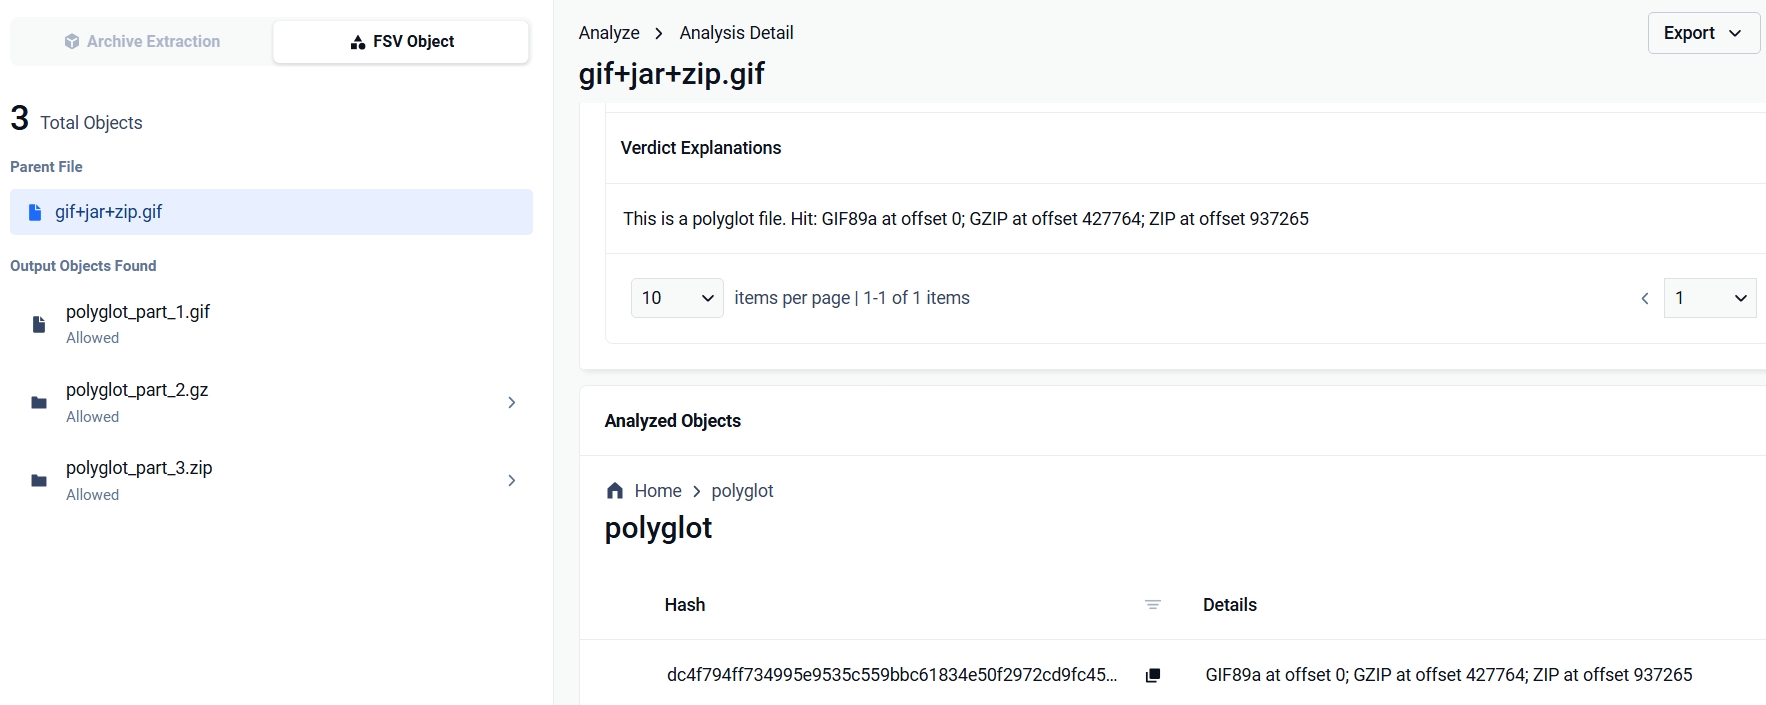
GIF contenente un flusso GZIP e un archivio Java | GIF89a @ 0 · GZIP @ 427.764 · ZIP @ 937.265 | Bloccato |
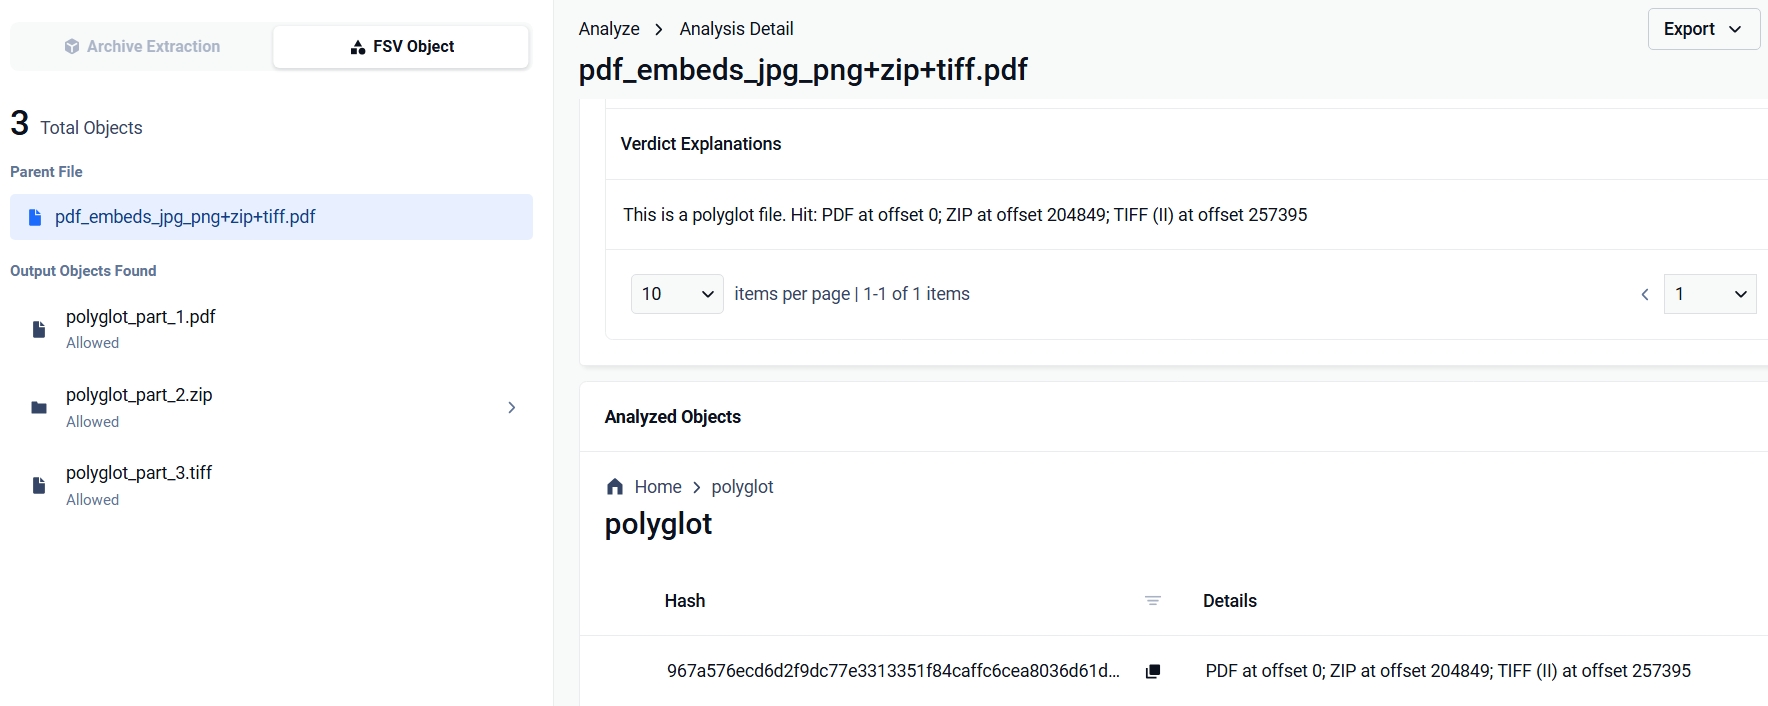
PDF contenente un file JPG e un file PNG, con un file ZIP e un file TIFF allegati | PDF @ 0 · ZIP @ 204.849 · TIFF @ 257.395 | Bloccato; le immagini incorporate non vengono correttamente segnalate |
L'ultima riga mostra la regola di esclusione in azione: il verdetto identifica i file ZIP e TIFF allegati e ignora le immagini contenute nel PDF. Il resolver del contenitore le ha considerate come parte del contenuto del PDF stesso. Il JSON del risultato di MetaDefender Core™ per quel file (versione abbreviata):
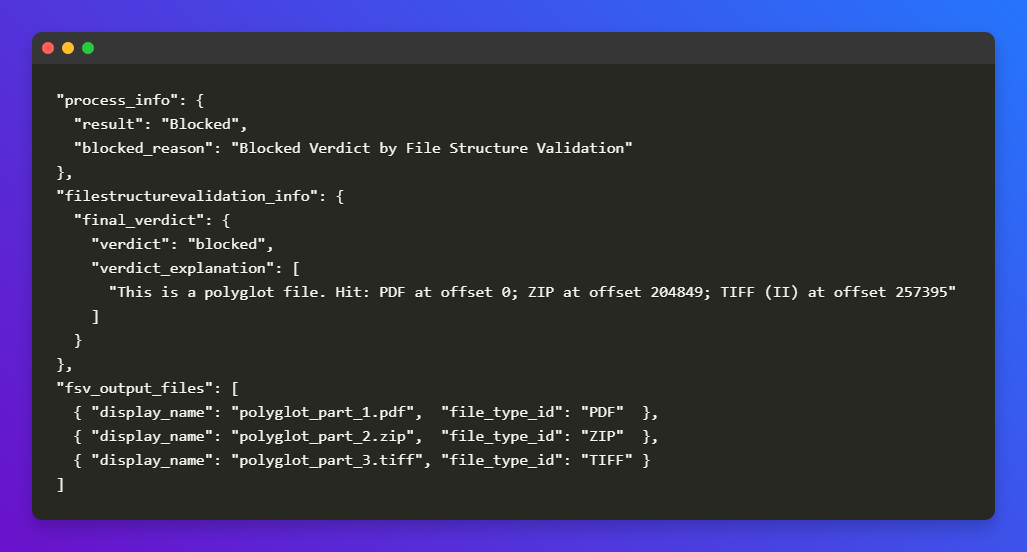
L'elenco fsv_output_files rappresenta la dissezione descritta sopra, in tempo reale: le tre facce sono state ricavate e restituite al flusso di lavoro come oggetti a sé stanti.
Ecco gli screenshot dei risultati di ciascun esempio in MetaDefender Core™:
Copertura e configurazione
La copertura attuale comprende i formati che gli autori degli attacchi combinano effettivamente: PDF, ZIP, file composti OLE, PNG, GIF, JPEG, TIFF, RAR, GZIP e 7z.
La risoluzione strutturale della fine del contenitore si applica ai formati dei contenitori. La funzionalità viene fornita con un approccio basato sulla configurazione: il rilevamento, il blocco e la scansione completa dei file sono tutti parametri configurabili tramite policy, pertanto gli operatori possono scegliere tra visibilità e applicazione delle regole a livello di implementazione.
Il bilancio
Un file contenente due tipi di faccia validi mette in difficoltà qualsiasi pipeline che gli assegni un unico tipo, e il rilevamento di tipo singolo è il principio su cui si basano la maggior parte degli stack di scansione. Il rilevamento strutturale poliglotta colma questa lacuna individuando ogni tipo di faccia e verificandone la validità. La policy può quindi bloccare il file prima che un’applicazione scelga l’interprete sbagliato.
Attualmente è supportato il rilevamento dei formati di attacco più comuni. La risoluzione dei file di fine contenitore per i restanti formati di archivio è prevista nella roadmap.
Scopri come la funzione di convalida della struttura dei file gestisce i formati di file che transitano nel tuo ambiente.